

0
会員(無料)になると、いいね!でマイページに保存できます。
共有する
テンセントのARC Labなどの研究チームは、ゲームを操作するAIの後訓練手法「Player-1」を論文で発表した。論文によると、合成環境16種での強化学習により、Minecraft上の300タスクの成功率を9Bモデルで38.33%まで引き上げ、比較対象で最も高いGameWAMの約3倍に達したという。

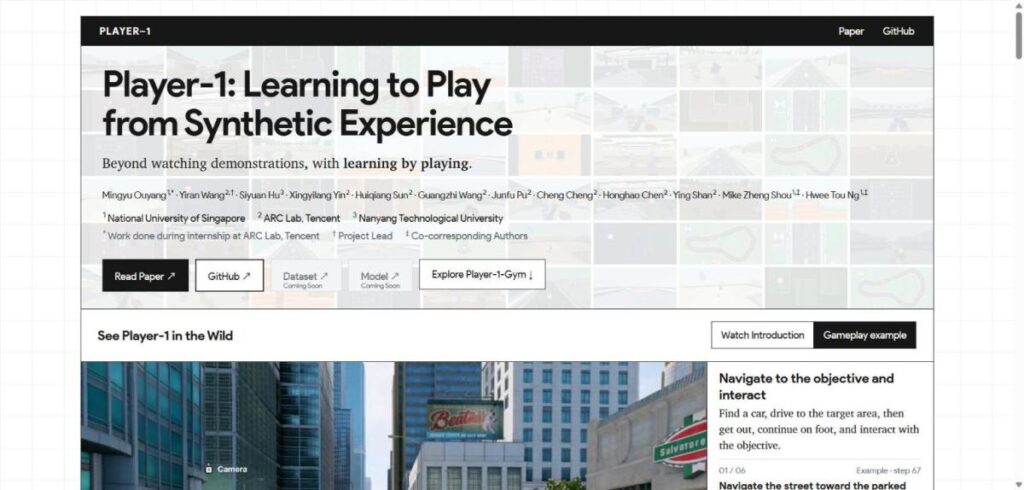
ゲーム操作AIの後訓練手法「Player-1」の公式プロジェクトページ
テンセントのARC Labなどの研究チームは、ゲームを操作するAIの後訓練手法「Player-1」を論文で発表した。論文はarXivに10月14日付で公開された。録画されたプレイの模倣だけに頼る手法を、合成環境での強化学習で大きく上回ったという。
論文によると、画面を読み取ってキーボードとマウスを操作するコンピューター操作エージェントは登場しているものの、ゲームは依然として難しい課題だという。Player-1は、AIが選べる行動に、相対的なポインタ移動、持続的な入力、複数の入力を組み合わせた複合アクションを加えた。
学習は2段階で進める。まず、録画された操作に指示と視覚的な推論を組み合わせた6,044件のゲームプレイ軌跡で、教師ありファインチューニング(SFT)を行う。続いて、2Dと3Dの合成環境16種からなる「Player-1-Gym」で、検証可能な報酬と、観測や操作の力学のランダム化を使い、強化学習のPPOで鍛える。モデルはQwen3.5-9BとQwen3.5-35B-A3Bから初期化し、「Player-1-9B」「Player-1-35B-A3B」とした。
評価では、Minecraft上の300タスクで構成する「MineDojo-300」の成功率が、SFT版に比べてPlayer-1-9Bで27.8ポイント、Player-1-35B-A3Bで17.7ポイント向上した。Player-1-9Bの成功率は38.33%で、論文が比較した他のモデルで最も高いGameWAMの12.63%の約3倍にあたる。ViZDoomの10マップによる「ViZDoom-10」と、ブラウザゲームの「GameWorld」でも、SFT版を上回った。
論文はこのほか、合成環境の種類が多いほど、学習に使っていないゲームへの転移性能が高まることや、強化学習の間に複合アクションの使用が増えたことも報告している。
GitHubでプロジェクトのリポジトリが公開されている。ただしREADMEによると、モデルの重みとPlayer-1-Gymは「Coming Soon」で、学習と評価のコードも未公開という。ライセンスはMITとしている。
では、全体で約3倍という成功率の内訳には、どんな偏りがあるのか。タスクの種類別の成績表と、強化学習の途中で急増したある行動の数字が、見出しの数字からは見えない姿を示している。

MineDojo-300、タスク種類別の成功率
(出典:論文をもとに作成)
この記事の続き >>
・Minecraftの戦闘と採集、成功率に開いた大きな差
・比較対象のゲームAIと基盤モデルの成績を並べる
・強化学習の途中で使用率が急増した「複合アクション」
この続きは
会員限定(完全無料)です
ここから先は「ビジネス+IT」会員に登録された方のみ、ご覧いただけます。
今すぐビジネス+IT会員に
ご登録ください。
すべて無料!今日から使える、
仕事に役立つ情報満載!
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
完全無料
登録料・月額料なし、完全無料で使い放題!
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
AI・生成AIのおすすめコンテンツ
Googleで見つけやすく
評価する
いいね!でぜひ著者を応援してください
会員(無料)になると、いいね!でマイページに保存できます。
関連タグ